
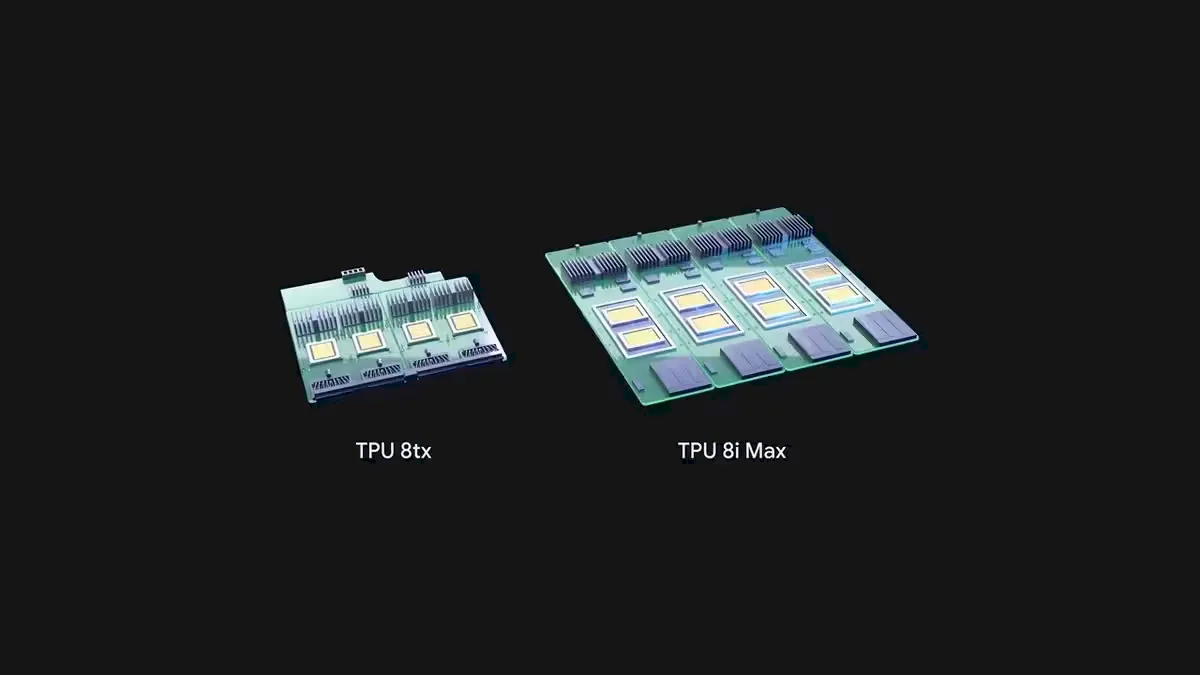
O Google anunciou duas novas configurações de seus aceleradores de inteligência artificial: Google TPU 8tx e TPU 8i Max. A primeira foi desenvolvida para processamento confidencial de dados, enquanto a segunda amplia memória e capacidade de processamento para tarefas com contextos muito extensos e múltiplos agentes de IA..
Os chips TPU do Google são fundamentais para acelerar aplicações de IA, especialmente em data centers e plataformas de nuvem.
Recentemente, o Google anunciou a expansão de sua série de Unidades de Processamento Tensor (TPU) com os novos modelos Google TPU 8tx e 8i Max.
Agora, o TPU 8i Max dobra a capacidade de memória HBM e a densidade de silício, enquanto o 8tx destaca-se por oferecer inferência confidencial com proteção avançada em nível de hardware.
Muitos especialistas consideram que, até agora, as opções em aceleradores de IA focavam demais em soluções genéricas, deixando lacunas importantes em segurança, eficiência e personalização para workloads específicas.
Neste artigo, vamos explorar detalhadamente as características técnicas, os diferenciais e os impactos desses chips, apresentando uma visão clara para quem quer entender a fundo o mercado de hardware para inteligência artificial.
Introdução aos chips Google TPU 8tx e 8i Max
Vamos começar entendendo o que são os chips TPU 8tx e 8i Max. Eles fazem parte da linha avançada de aceleradores do Google para inteligência artificial, focados em diferentes tipos de cargas de trabalho.
O que são TPUs?
As TPU, ou Tensor Processing Units, são chips criados pelo Google para acelerar a IA. Elas processam funções complexas, como multiplicações de matrizes, muito usadas em redes neurais. Diferente das CPUs comuns, as TPUs são mais rápidas e gastam menos energia.
Essas unidades aparecem em aplicações como modelos generativos, sistemas de recomendação e agentes autônomos. O Google oferece esses chips pelo Google Cloud, para empresas que precisam de muita potência para IA.
Evolução da série TPU do Google
A oitava geração de TPUs trouxe quatro versões diferentes em um só ano. A 8t é para treinar modelos grandes, 8i trabalha com raciocínio rápido, 8tx foca em segurança com computação confidencial, e 8i Max lida com janelas de contexto muito maiores.
Essa divisão mostra como o Google deixou o hardware mais especializado, pensando em cargas específicas de IA, como agentes inteligentes e modelos com longas sequências de dados.
Principais diferenças entre 8tx e 8i Max
A TPU 8tx inclui proteção em nível de hardware para dados estratégicos — é ideal para inferência confidencial. Já a 8i Max junta dois chips 8i, duplicando o poder de processamento e a memória, que chega a 768 MB de SRAM.
Isso ajuda muito em tarefas que precisam processar muita informação ao mesmo tempo, como agentes de IA e modelos de linguagem com longos contextos. Enquanto a 8tx é usada para segurança em dados sensíveis, a 8i Max é focada em força bruta computacional.
Arquitetura e desempenho dos TPUs de 8ª geração
Vamos entender a arquitetura e o desempenho dos TPUs da 8ª geração. Eles são feitos para rodar tarefas complexas de IA de forma rápida e eficiente.
Memória HBM e SRAM: função e importância
A memória HBM e a SRAM são cruciais para o desempenho dos TPUs. A HBM armazena os modelos grandes e os dados usados, enquanto a SRAM guarda informações rapidamente acessadas, como caches, perto das unidades de computação.
No TPU 8t, a HBM tem 216 GB e 128 MB de SRAM. Já o 8i tem 288 GB de HBM e 384 MB de SRAM, o que reduz atrasos e acelera o processamento.
Capacidade de processamento e eficiência energética
Os TPUs de 8ª geração entregam altíssimo poder de processamento com alta eficiência. Um superpod do 8t pode ter até 9.600 chips e 121 exaFLOPs FP4, com 2 PB de memória HBM.
Além disso, eles são até 2 vezes mais eficientes em consumo de energia e 2,7 vezes mais econômicos por desempenho em comparação com gerações anteriores.
Comparação de desempenho com GPUs NVIDIA
Em certas tarefas, os TPUs são quase 3 vezes mais eficientes energeticamente do que as GPUs NVIDIA H100. Eles se destacam em cargas específicas de IA, como modelos MoE e agentes autônomos, graças à memória compartilhada e integração em escala.
Porém, GPUs NVIDIA ainda ganham em flexibilidade e compatibilidade, então a escolha depende do tipo de trabalho e escala necessária.
Segurança e inferência confidencial no TPU 8tx
O TPU 8tx traz avanços importantes em segurança para IA confidencial. Ele protege dados mesmo durante o processamento, algo fundamental hoje em dia.
Proteções em hardware para dados sensíveis
O 8tx usa proteções em hardware para proteger dados sensíveis. Ele combina silício avançado com CPUs AMD EPYC, e implementa criptografia contínua para prompts, pesos e dados intermediários.
Isso evita o vazamento de informações enquanto o modelo roda, garantindo isolamento rígido e verificação antes do acesso à memória.
Benefícios da inferência confidencial
A inferência confidencial protege dados “mesmo em uso” com quase nenhum impacto no desempenho. A latência do 8tx é metade da versão anterior, permitindo ajustes privados e treinamentos dentro de um ambiente seguro.
Isso reduz riscos de exposição e facilita conformidade, mantendo os modelos seguros e operando em clusters isolados.
Casos de uso em setores regulados
Setores regulados se beneficiam muito do TPU 8tx. Bancos, governos e órgãos com dados sensíveis treinam IA e agentes autônomos protegidos pela tecnologia.
Esse nível de segurança protege dados, modelos e execução, essencial para operações com informações críticas e confidenciais.
Integração com Google Cloud e frameworks de IA
Integrar os TPUs de última geração com o Google Cloud e frameworks de IA é simples e poderoso. Essa combinação permite criar e rodar modelos complexos com facilidade e escala.
Como acessar e contratar TPUs no Google Cloud
Para acessar TPUs no Google Cloud, você cria TPU VMs ou usa clusters Kubernetes (GKE). Escolhe a versão, a região e a quantidade desejada.
O modelo de pagamento é pay-as-you-go, o que significa que só paga pelo que usar, com descontos para uso contínuo ou pré-pago.
Suporte a frameworks populares como PyTorch e TorchTPU
O TorchTPU é um backend nativo e open source para PyTorch criado pelo Google e Meta. Ele permite rodar modelos PyTorch com poucas mudanças, trocando comandos para rodar no TPU.
Além do PyTorch, outras ferramentas como JAX e vLLM também têm suporte, facilitando o desenvolvimento diversificado.
Otimização de cargas de trabalho de IA
A otimização envolve técnicas como fusão de operações, compilação e particionamento para acelerar o processamento. Um exemplo prático reduziu o tempo de treino em mais de 2 vezes.
Para garantir bom desempenho, é importante ajustar o tamanho dos lotes, a topologia do cluster e controlar recompilações.
Comparação e competição com hardware NVIDIA
Os TPUs do Google desafiam as GPUs da NVIDIA em alguns pontos-chave, mas enfrentam também limitações. Conhecer essas diferenças ajuda a entender onde cada tecnologia brilha.
Vantagens dos TPUs para workloads específicos
Os TPUs são otimizados para cargas pesadas de IA, principalmente modelos MoE e agentes autônomos. Sua arquitetura integra memória compartilhada e alta escala em um único sistema, garantindo eficiência em treinamentos complexos.
Além disso, os TPUs entregam alta largura de banda e menor latência para alguns tipos de inferência, o que reduz o tempo e custo.
Desafios técnicos frente às GPUs NVIDIA
Apesar da eficiência, os TPUs ainda têm desafios de compatibilidade e flexibilidade comparados às GPUs NVIDIA. Essas últimas suportam mais frameworks, oferecem maior variedade de precisão e são amplamente utilizadas em diferentes setores.
Também há limitações para workloads que não são estritamente focados em IA, o que pode exigir GPUs para aplicações híbridas.
Tendências futuras em aceleradores de IA
O futuro aponta para aceleradores cada vez mais especializados e integrados com inteligência na nuvem. Google investe em inferência confidencial e CPUs integradas, enquanto a NVIDIA aposta em hardware versátil e ecossistemas robustos.
Espera-se uma convergência gradual, onde a escolha do acelerador dependerá do uso específico e custo-benefício detalhado.
Conclusão
Os novos chips TPU 8tx e 8i Max representam um avanço significativo no campo da inteligência artificial. Eles combinam alto desempenho, segurança reforçada e especialização para diferentes cargas de trabalho, desafiando concorrentes como a NVIDIA.
O TPU 8tx se destaca por sua inferência confidencial com proteções em nível de hardware, enquanto o 8i Max traz maior capacidade de memória e computação para modelos extensos.
Além disso, a integração com o Google Cloud e o suporte a frameworks modernos facilitam o acesso e a otimização das soluções.
Esse avanço demonstra uma tendência clara: os aceleradores de IA estão ficando cada vez mais especializados, eficientes e focados em segurança, abrindo caminho para aplicações mais robustas e confiáveis.
Key Takeaways
Conheça os avanços essenciais dos chips TPU 8tx e 8i Max do Google para revolucionar o hardware de inteligência artificial.
- Especialização em IA: TPU 8tx e 8i Max são projetados para cargas específicas, melhorando desempenho em inferência confidencial e processamento de grandes janelas de contexto.
- Memória avançada: O TPU 8i Max oferece 768 MB de SRAM e maior largura de banda HBM, reduzindo gargalos em modelos de linguagem extensos.
- Segurança reforçada: TPU 8tx destaca-se pela proteção em hardware, mantendo dados, modelos e execuções criptografadas durante processamento.
- Integração prática: Acesso facilitado via Google Cloud com pagamento pay-as-you-go e suporte nativo a frameworks como PyTorch e TorchTPU.
- Otimização eficaz: Técnicas como fusão de operações e compilação com torch.compile aumentam a velocidade e eficiência dos modelos.
- Comparação com NVIDIA: TPU entrega maior eficiência energética em cargas específicas, mas GPUs NVIDIA têm maior flexibilidade e compatibilidade.
- Aplicações reguladas: TPU 8tx atende setores que exigem alta segurança, como bancos e governo, protegendo informações sensíveis.
- Foco futuro: A tendência é aceleradores cada vez mais especializados e integrados, focando performance, segurança e escalabilidade.
Entender esses pontos é fundamental para aproveitar os benefícios dos novos aceleradores e posicionar-se na vanguarda da tecnologia em inteligência artificial.
Key Takeaways
- O Google lançou dois novos aceleradores TPU: o TPU 8tx, focado em inferência confidencial e proteção de dados em nível de hardware, e o TPU 8i Max, voltado para maior memória e capacidade de processamento para contextos muito extensos.
- O TPU 8i Max duplica a densidade de silício e a memória SRAM (chegando a 768 MB) e aumenta a HBM, permitindo processar janelas de contexto maiores e cargas intensas como agentes de IA e modelos de linguagem extensos.
- O TPU 8tx oferece inferência confidencial com criptografia contínua e isolamento rígido em hardware, reduzindo riscos de vazamento de informações e mantendo baixa latência para workloads sensíveis (setores regulados como bancos e governo).
- A integração com Google Cloud facilita o acesso (TPU VMs, GKE, modelo pay-as-you-go) e há suporte a frameworks populares como PyTorch via TorchTPU, JAX e vLLM, além de técnicas de otimização para melhorar desempenho.
- Os TPUs de 8ª geração entregam alto desempenho e eficiência energética (em certas tarefas superando GPUs NVIDIA), especialmente em MoE e agentes autônomos, mas GPUs mantêm vantagem em flexibilidade e compatibilidade; tendência para aceleradores mais especializados.
